
Los objetos DataFrame de Pandas son una herramienta fantástica para trabajar con datos, permitiendo realizar múltiples tareas de una forma rápida y sencilla. Una de las más habituales es filtrar y seleccionar un subconjunto de los datos en función de los valores de una o varias columnas.
Cuando empezamos a trabajar con Pandas y Python, una de las principales operaciones que hay que aprender es la selección de filas de un DataFrame que cumplan un determinado criterio.
- Necesito obtener todos los asistentes a un congreso que tengan menos de 35 años.
- Necesito el listado de clientes que se hayan registrado antes del 23 de marzo de un determinado año.
- Necesito obtener aquellos empleados que trabajen en el departamento de atención al cliente y que tengan una antigüedad de menos de tres meses.
Se trata de filtrar un DataFrame para obtener aquellas filas en las que los valores de sus columnas cumplan una o varias condiciones.
A modo de ejemplo, en esta entrada se utilizará el conjunto de datos de exoplanetas que se puede encontrar en la librería Seaborn.
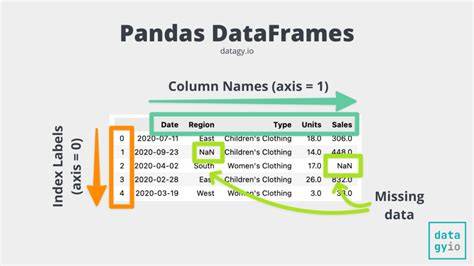
Filtrar un DataFrame por el valor de una columna
La operación básica de filtrado consiste en seleccionar aquellos valores que cumplen una condición. Para ello se puede comparar una columna con el valor deseado y obtener una lista de valores verdaderos o falsos.
Para conseguir un nuevo DataFrame solamente con estos planetas, simplemente se ha de usar in_2018 como filtro. No es necesario guardar el filtro en una variable; simplemente se puede utilizar la operación directamente como filtro.
Ejemplo:
planets_2008 = planets[planets['year'] == 2008]
En este caso, la expresión planets['year'] == 2008 genera un array booleano con un valor para cada fila. Las filas cuyo valor sea True se conservan en el nuevo DataFrame.
Indexación booleana en Pandas
La indexación booleana en Pandas permite seleccionar de forma sencilla los elementos de un DataFrame en función de que los valores de una o varias filas cumplan ciertas condiciones.
Solamente se debe crear un vector booleano con el valor True en las filas que se desean seleccionar. Esto es fácil cuando la condición se debe comparar con un único valor: solamente se debe escribir la condición lógica.
La propiedad loc nos permite obtener un conjunto de filas de un DataFrame por su etiqueta o mediante un array de booleanos. En este caso, lo que interesa es la segunda opción.
El funcionamiento es muy sencillo. Si proporcionamos a la propiedad loc de un DataFrame un array con tantos valores booleanos como filas tiene el DataFrame, devolverá solamente aquellas filas en las que el array tiene el valor True.
Dicho de otra manera, si tenemos un DataFrame con 3 filas, por ejemplo fila_1, fila_2 y fila_3, y le proporcionamos a loc el array True, False, True, el resultado será un nuevo DataFrame con las filas fila_1 y fila_3.
Sabiendo esto, el problema se reduce a generar ese array de booleanos, poniendo True en aquellas filas que nos interesan y False en las que no queremos.
Para ello podemos hacer uso de la notación de corchetes de un DataFrame para acceder a las columnas y de un conjunto de comparadores y operadores booleanos.
Filtrar filas con la propiedad loc
Para seleccionar filas de un DataFrame de Pandas en Python se puede utilizar la propiedad loc, indicando entre los corchetes las condiciones que deben cumplir los valores de sus columnas.
Por ejemplo:
df.loc[dt[columna]==valor]
Alternativamente, se puede usar la función query.
Variantes equivalentes
La selección puede expresarse mediante las siguientes variantes equivalentes:
- df.loc[df[columna]==valor]
- df[df[columna]==valor]
- df[df.columna==valor]
La notación con corchetes permite acceder a las columnas directamente mediante su nombre. La notación abreviada puede resultar más cómoda, aunque el acceso mediante atributos no siempre es adecuado para nombres de columnas que contienen espacios, caracteres especiales o coinciden con nombres de métodos.
Operadores de comparación en Pandas
En Pandas podemos comparar los valores de una columna con los siguientes operadores:
| Operador | Uso |
|---|---|
| == | Comprobación de igualdad. |
| != | Comprobación de no igualdad. |
| < | Menor que. |
| <= | Menor o igual que. |
| > | Mayor que. |
| >= | Mayor o igual que. |
La comparación de igualdad comprueba si el valor de una columna es igual a otro: ==.
La comparación de no igualdad comprueba si el valor de una columna es diferente a otro: !=.
Las comparaciones de menor que, menor o igual que, mayor que y mayor o igual que se realizan mediante los operadores <, <=, > y >=.
Ejemplos de condiciones sencillas
Para seleccionar las filas cuya columna tenga un valor concreto se puede utilizar una expresión como la siguiente:
df[df['columna'] == valor]
Para seleccionar los valores diferentes de un determinado valor:
df[df['columna'] != valor]
Para seleccionar los valores menores de 40:
df[df['Edad'] < 40]
Para seleccionar los valores mayores o iguales que 200000:
df[df['Votos'] >= 200000]
Filtrar valores que no coinciden
De forma análoga a como se han seleccionado los registros que cumplen una condición, se pueden seleccionar aquellos que no la cumplen.
Ahora simplemente el filtro se puede conseguir mediante el operador de no igualdad.
Por ejemplo, para obtener todos los empleados que no sean Juan:
resto = empleados.loc[~(empleados['Nombre'] == 'Juan')] # alternativa 2
También se puede utilizar directamente el operador !=:
empleados[empleados['Nombre'] != 'Juan']
Cualquiera de estos operadores se puede negar para realizar la comprobación opuesta o contraria anteponiendo el operador ~ a la condición.
Filtrar columnas que no tienen un valor
En muchos conjuntos de datos es habitual que existan registros con valores nulos. Para identificar los registros nulos, los objetos de Pandas cuentan con los métodos isnull() y notnull().
Tal como indica el nombre, isnull() devuelve verdadero en los registros nulos y notnull() en los que no son nulos.
Aplicando estos métodos a una columna se puede saber qué registros cumplen una condición u otra.
Para seleccionar las filas en las que una columna contiene valores nulos:
df[df['columna'].isnull()]
Para seleccionar las filas en las que una columna no contiene valores nulos:
df[df['columna'].notnull()]
Filtrar por varios valores con isin()
Los filtros anteriores son bastante útiles, pero en muchas ocasiones se desea seleccionar datos cuyos valores se encuentran en una lista.
Para ello se puede aplicar el método isin() a las columnas para obtener un filtro.
En un DataFrame de Pandas se pueden seleccionar las filas en función de sus valores usando indexación booleana. Cuando se tiene que usar más de un valor, se pueden combinar las condiciones.
Algo resulta sencillo cuando son dos o tres valores, pero se hace tedioso cuando son más de dos valores. Para estos casos se puede recurrir al método isin() de los objetos DataFrame.
El método isin() de los DataFrame de Pandas recibe una lista de valores y devuelve verdadero cuando el elemento de cada uno de los elementos de la Serie o DataFrame está en esa lista, y falso en el resto de los casos.
Así, realizar el filtrado en base a una lista se vuelve más sencillo: no es necesario escribir más código ni usar un bucle cuando aumenta el número de valores a comprobar.
Solamente se debe usar el resultado del método como condición de filtrado.
Ejemplo con una lista de edades
Vamos a obtener los empleados que tengan 39 o 43 años:
edad_39_43 = empleados[empleados.Edad.isin((39, 43))]
También se puede escribir utilizando la notación con corchetes:
edad_39_43 = empleados[empleados['Edad'].isin((39, 43))]
En este caso se ha creado una lista que se pasa como parámetro al método isin(), siendo el resultado del método lo que se usa para el filtrado.
Seleccionar elementos que no están en una lista
Si se desea conocer los registros que no están en una lista, mediante el operador de negación ~ se puede invertir el filtro.
Por ejemplo:
empleados[~empleados['Edad'].isin((39, 43))]
En este caso solamente se ha interpuesto el operador de negación lógica para invertir la selección.
Combinar varias condiciones
Finalmente se pueden combinar varios filtros mediante el uso de los operadores & y |.
Estos comparadores y la negación se pueden combinar creando condiciones múltiples con los siguientes operadores y agrupando con paréntesis según sea necesario.
- Operador and: combina dos condiciones que deben ser True para obtener True en toda la expresión. El símbolo del operador es &.
- Operador or: combina dos condiciones en las que al menos una de ellas debe ser True para obtener True en toda la expresión. El operador es |.
El operador & equivale a un «y»: las dos condiciones deben cumplirse al mismo tiempo.
El operador | equivale a un «o»: basta con que se cumpla al menos una de las condiciones.
Filtrar con OR
Se pueden obtener los empleados que trabajen en el departamento de Administración o aquellos que tengan más de 2 trienios usando el operador |:
adm_trienios_2 = empleados.loc[(empleados['Departamento'] == 'Administración') | (empleados['Trienios'] >= 2)]
Filtrar con AND
Se pueden obtener los empleados que no trabajen en el departamento de Ventas y que tengan menos de 43 años usando el operador &:
no_ventas_43 = empleados.loc[(empleados['Departamento'] != 'Ventas') & (empleados['Edad'] < 43)]
Condiciones combinadas con pertenencia
También se pueden combinar varias condiciones con isin(), comparadores y operadores booleanos.
Por ejemplo, se pueden seleccionar empleados cuyo departamento pertenezca a una lista y cuya edad esté por debajo de un límite:
empleados[(empleados['Departamento'].isin(['Administración', 'Dirección'])) & (empleados['Edad'] < 43)]
La importancia de los paréntesis
¡Cuidado! Los operadores ~, & y | tienen menor precedencia que los comparadores vistos previamente, al revés de lo que sucede con las condiciones de Python.
Por ello es necesario utilizar paréntesis para agrupar las expresiones y obtener los resultados deseados.
La forma recomendable de escribir una condición múltiple es:
df[(df['columna_a'] == valor_a) & (df['columna_b'] > valor_b)]
Para una condición alternativa:
df[(df['columna_a'] == valor_a) | (df['columna_b'] > valor_b)]
La ausencia de paréntesis puede producir errores o resultados distintos de los esperados.
Ejemplo completo con un DataFrame de empleados
Vamos a suponer que tenemos un DataFrame con los datos de los empleados de una pequeña empresa. Para cada empleado tendremos su nombre, edad, departamento de la empresa al que pertenece y el número de trienios de antigüedad.
Para cargar estos datos en un DataFrame vamos a hacerlo de manera rápida, creándolo a partir de un diccionario, creando un elemento en un diccionario para cada columna, donde la clave es el nombre de la columna y el valor es una lista con los elementos de dicha columna:
empleados = pd.DataFrame(datos)
Buscar un empleado por nombre
Empecemos con algo sencillo y directo. Vamos a obtener los empleados que se llaman Juan.
empleados.loc[empleados['Nombre'] == 'Juan']
Si te fijas, es justo la cuarta fila, la de índice 3, la que contiene un True mientras que las demás están a False, que es justamente la fila que corresponde con el empleado Juan.
El resultado corresponde al empleado Juan, de 43 años, del departamento de Dirección y con 4 trienios.
Obtener empleados menores de 40 años
Para obtener los empleados menores de 40 años se puede utilizar:
empleados.loc[empleados['Edad'] < 40]
El resultado incluye, entre otros, a Marco, de 37 años, que trabaja en Ventas y tiene 3 trienios.
Obtener empleados por varios criterios
Para obtener los empleados que trabajen en el departamento de Administración o aquellos que tengan más de 2 trienios:
adm_trienios_2 = empleados.loc[(empleados['Departamento'] == 'Administración') | (empleados['Trienios'] >= 2)]
Para obtener aquellos empleados que no trabajen en el departamento de Ventas y que tengan menos de 43 años:
no_ventas_43 = empleados.loc[(empleados['Departamento'] != 'Ventas') & (empleados['Edad'] < 43)]
Para obtener los empleados que tengan 39 o 43 años:
edad_39_43 = empleados[empleados.Edad.isin((39, 43))]
Filtrar filas con query()
Otra opción similar para la selección de filas basada en los valores de las columnas consiste en el uso de la función query de la clase DataFrame.
La función query de Pandas es una herramienta poderosa para filtrar y seleccionar datos de un DataFrame. Con ella es posible escribir consultas en lenguaje natural para seleccionar filas de un DataFrame que cumplan ciertas condiciones.
Esta función permite indicar el criterio para seleccionar las filas de una manera parecida, salvando las distancias, a cómo se hace en SQL, Structured Query Language, en la cláusula WHERE.
A query se le proporciona como parámetro un string o cadena de texto con las condiciones que necesitamos que se cumplan, utilizando los operadores vistos hasta ahora y los nombres de las columnas.
La forma general es:
df.query('columna==valor')
Filtrar por un valor de texto
Por ejemplo, si queremos obtener el usuario llamado Juan, basta con indicar:
empleados.query('Nombre == "Juan"')
Hay que tener en cuenta que es necesario utilizar comillas en las constantes de texto.
Filtrar por varios valores
El ejemplo de selección de edades se puede escribir con query() de la siguiente manera:
edad_39_43 = empleados.query('Edad in (39, 43)')
Si te fijas, las expresiones son ahora más cortas y fáciles de leer.
Usar operadores lógicos en query()
También se pueden combinar varias condiciones dentro de la consulta:
df.query('A + B > C & T != "t300"')
Esta expresión selecciona las filas cuya suma de valores de las columnas A y B sea superior al valor de la columna C y cuya columna T sea diferente de t300.
Si se necesita utilizar en el parámetro de query el valor de alguna variable, se puede hacer uso de los f-strings.
Ejemplos de query() con datos electorales
Tenemos un Dataset y vamos a responder a unos problemas, pero antes entraremos a detalle con el Dataset que vamos a analizar.
Este código importa la biblioteca pandas y utiliza el método read_csv() para leer un archivo CSV específico y almacenarlo en una variable df, un DataFrame de pandas.
La ruta especificada en la función read_csv es donde se encuentra el archivo a ser leído y cargado en el DataFrame.
Filtrar un estado y agrupar los resultados
Utilizamos el método query() de Pandas para filtrar los datos del dataframe y guardar solamente las filas donde la columna Estado es igual a New York en un nuevo dataframe llamado df1.
Luego utilizamos el método groupby() para agrupar los datos en df1 por la columna Estado y después utilizamos el método sum() para sumar los valores de la columna Votos para cada grupo.
df1.groupby(["Estado"]).sum()["Votos"]
En New York hubo 2686539 votos.
Filtrar votos mayores o iguales que 200000
Utilizamos el método query() para filtrar los datos del dataframe y guardar solamente las filas donde la columna Votos es mayor o igual a 200,000 en un nuevo dataframe llamado df2.
Luego imprimimos el contenido del dataframe df2.
Como podemos ver, todos los votos son mayores a 200,000.
Filtrar por candidato y número de votos
Utilizamos el método query() para filtrar los datos del dataframe y guardar solamente las filas donde la columna Candidato es igual a Donald Trump y la columna Votos es mayor a 100,000 en un nuevo dataframe llamado df3.
Luego imprimimos el contenido del dataframe df3.
Como podemos observar, el candidato que se muestra solamente es Donald Trump y los votos son mayores a 100000.
Comprender el operador OR
Utilizamos el método query() de Pandas para filtrar los datos del dataframe y guardar solamente las filas donde la columna Votos es mayor a 15,000 o la columna Partido es igual a Democrat y la columna Estado es igual a California en un nuevo dataframe llamado df4.
Imprimimos el contenido del dataframe df4.
Vemos que se filtró el Estado de California, pero en Partido vemos Democrat y también Republican, y no solo eso, sino que vemos Votos mayores a 15000 y también menores.
Esto sucede por el operador OR, que cumple su función de que al menos se cumpla una de las dos condiciones dadas para poder mostrarse.
Filtrar con varias alternativas dentro de una condición
Se utiliza el método query() de Pandas para filtrar los datos del dataframe y guardar solamente las filas donde la columna Estado es igual a Alabama, la columna Condado es igual a Jefferson o Madison y la columna Votos es mayor a 10,000 en un nuevo dataframe llamado df5.
Imprimimos el contenido del dataframe df5.
Vemos que se muestra el Estado de Alabama, también vemos que los Votos son mayores a 10,000, pero vemos en la columna de Condado el resultado de Jefferson y de Madison.
Al igual que en el caso anterior, aplicamos el operador OR para filtrar tanto el primer filtro como el segundo filtro.
Filtrar utilizando operaciones matemáticas entre columnas
El filtrado condicional basado en criterios matemáticos es una técnica importante en el análisis de datos y la estadística, que permite seleccionar subconjuntos específicos de datos bajo ciertas condiciones matemáticas.
En este contexto, los criterios matemáticos son condiciones que los datos deben cumplir para ser seleccionados. Estos criterios pueden ser expresiones algebraicas, desigualdades o funciones que definen los límites dentro de los cuales deben caer los datos.
La aplicación de estos criterios generalmente implica el uso de funciones de evaluación.
Aunque no lo hemos visto en todos los ejemplos, se pueden realizar operaciones matemáticas entre los valores de las columnas para crear criterios de selección complejos.
Por ejemplo:
df.query('A + B > C & T != "t300"')
Este criterio obtiene las filas cuya suma de los valores de las columnas A y B es superior al valor de la columna C y cuya columna T es diferente de t300.
Seleccionar datos mediante estadísticas descriptivas
La selección de datos en función de estadísticas descriptivas es un proceso importante en el análisis de datos que permite filtrar y enfocarse en subconjuntos específicos basados en características estadísticas.
Media y desviación estándar
La media y la desviación estándar son medidas centrales y de dispersión fundamentales.
La selección puede realizarse considerando un número determinado de desviaciones estándar alrededor de la media.
Aquí, k es un parámetro que define el número de desviaciones estándar alrededor de la media dentro del cual se seleccionan los datos.
Mediana y rango intercuartílico
La mediana es una medida de tendencia central menos sensible a los valores extremos que la media.
El rango intercuartílico, IQR, es una medida de dispersión que describe la amplitud de la distribución entre el primer cuartil, Q1, y el tercer cuartil, Q3.
En este caso, IQR = Q3 - Q1.
Percentiles
Los percentiles dividen el conjunto de datos en 100 partes iguales.
La selección de datos en función de percentiles puede implicar el filtrado para concentrarse en un rango específico de percentiles, como el percentil 25 al 75.
Aquí, P25 y P75 representan el percentil 25 y el percentil 75, respectivamente.
Criterios basados en múltiples estadísticas
A menudo se utilizan combinaciones de diferentes estadísticas descriptivas para filtrar los datos.
En resumen, la selección de datos basada en estadísticas descriptivas permite enfocar el análisis en subconjuntos relevantes, mejorando la calidad y la interpretación de los resultados.
Segmentar un DataFrame en grupos y subconjuntos
La segmentación de datos en función de grupos y subconjuntos es una técnica crucial para el análisis de datos que permite dividir un conjunto de datos en partes más manejables y significativas.
Esta técnica facilita la comprensión de patrones, la identificación de relaciones entre variables y la toma de decisiones informadas.
- Las variables categóricas, como la región geográfica, el género o el tipo de producto, se utilizan para crear grupos o categorías dentro del conjunto de datos.
- Las variables continuas, como el ingreso, la edad o el puntaje de satisfacción, pueden dividirse en rangos o intervalos para crear grupos.
- Los métodos de clustering, como k-means, el clustering jerárquico o DBSCAN, segmentan los datos en función de similitudes entre las observaciones.
- El PCA puede utilizarse para reducir la dimensionalidad del conjunto de datos e identificar subconjuntos significativos basados en los componentes principales que explican la mayor variabilidad en los datos.
- La segmentación basada en el tiempo puede implicar dividir datos en función de periodos temporales, como años, meses, semanas o días.
La segmentación de datos en función de grupos y subconjuntos permite una comprensión más profunda y específica del conjunto de datos.
Rendimiento de loc y query
Se han visto varias opciones para hacer la selección de filas. Antes de elegir una u otra técnica, conviene considerar su efecto en el tiempo de ejecución.
Para realizar un pequeño estudio de rendimiento se crearon varios DataFrame de cuatro columnas. Tres de las columnas contienen números aleatorios entre 0 y 1, concretamente las columnas A, B y C, y la cuarta es una cadena de texto, la columna T, con el formato tN, donde N es un número aleatorio entre 100, 200, 300, 400 y 500.
El tamaño de los DataFrame varía entre las 10000 y las 50000 filas.
Se definió un criterio de selección: obtener las filas cuya suma de valores de las columnas A y B sea superior a la de la columna C y cuya columna T sea diferente de t300.
Se crearon dos funciones para aplicar la selección, una con la versión loc y otra con query.
return df.query('A + B > C & T != "t300"')
El siguiente paso fue llamar a cada una de estas funciones con cada uno de los DataFrame generados de distintos tamaños.
Se realizaron 1000 ejecuciones para cada combinación de criterio y DataFrame, con la ayuda de la librería timeit.
El resultado muestra que, para DataFrames de más de 30000 filas aproximadamente, resulta más eficiente la versión query, mientras que para los que son más pequeños lo mejor es optar por la versión loc.
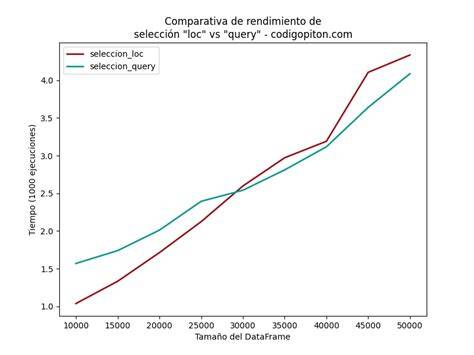
Esta es una pequeña prueba y es posible que al realizarla se obtengan resultados diferentes.
El rendimiento depende mucho del criterio utilizado. Cuanto más complejo sea, más tiempo se necesitará para hacer el filtrado.
También depende de la estructura y los tipos de datos del DataFrame.
Hay muchas variables, así que conviene hacer un estudio propio y decidir la mejor alternativa en función de cada proyecto.
| Tamaño aproximado del DataFrame | Alternativa observada como más eficiente |
|---|---|
| Menos de 30000 filas | loc |
| Más de 30000 filas | query |
La diferencia se refiere a las condiciones concretas de la prueba: el criterio utilizado, la estructura del DataFrame, los tipos de datos y el entorno de ejecución pueden modificar los resultados.
Referencia rápida de sintaxis
| Necesidad | Sintaxis |
|---|---|
| Igualdad | df[df['columna'] == valor] |
| No igualdad | df[df['columna'] != valor] |
| Menor que | df[df['columna'] < valor] |
| Mayor o igual que | df[df['columna'] >= valor] |
| Valores incluidos en una lista | df[df['columna'].isin(lista)] |
| Valores excluidos de una lista | df[~df['columna'].isin(lista)] |
| Dos condiciones simultáneas | df[(condición_1) & (condición_2)] |
| Una condición u otra | df[(condición_1) | (condición_2)] |
| Consulta con query | df.query('columna==valor') |
tags: #filtrar #dataframe #por #valor #de #columna
Publicaciones populares:
- Filtraciones en garajes: causas comunes y soluciones efectivas
- Guía para instalar filtros en campanas extractoras industriales
- Cómo devolver la claridad a una piscina con agua turbia
- Guía sobre mascarillas en centros educativos
- Conatal: opciones depurativas para la salud circulatoria y hepática